04. Variance & Standard Deviation — 분산과 표준편차는 무엇일까?

jay
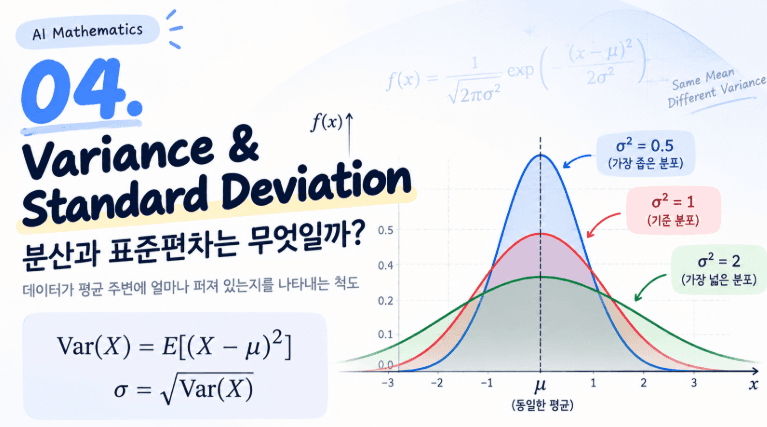
앞선 글에서는 확률변수(Random Variable)가 평균적으로 어떤 값을 가지는지를 설명하는 Expectation(기댓값)에 대해 살펴봤다.
기댓값을 알고 있다면 확률분포의 평균적인 위치를 파악할 수 있다. 하지만 기댓값 하나만으로 데이터의 모든 특성을 이해할 수 있는 것은 아니다.
예를 들어 두 데이터셋의 평균이 같더라도, 하나는 모든 값이 평균 근처에 몰려 있고 다른 하나는 값들이 넓게 퍼져 있을 수 있다.
이처럼 데이터가 평균을 중심으로 얼마나 퍼져 있는지를 설명하는 개념이 Variance(분산)이며, 이를 원래 데이터와 같은 단위로 표현한 값이 Standard Deviation(표준편차)이다.
이번 글에서는 분산과 표준편차가 왜 필요한지, 수식은 어떻게 정의되는지, 그리고 머신러닝에서 어떻게 활용되는지 정리한다.
왜 Variance가 필요할까?
다음 두 데이터셋을 생각해보자.
| 데이터셋 | 관측값 | 평균 |
|---|---|---|
| A | 4, 4, 4 | 4 |
| B | 2, 4, 6 | 4 |
두 데이터셋의 평균은 모두 4이다.
하지만 데이터를 자세히 보면 차이가 있다. A는 모든 값이 평균과 같지만, B는 평균을 기준으로 양쪽에 값들이 퍼져 있다.
따라서 평균만 보고 두 데이터셋이 동일한 특성을 가진다고 판단할 수는 없다.
Expectation은 분포의 평균적인 위치를 설명하고, Variance는 평균으로부터 값들이 얼마나 퍼져 있는지를 설명한다.
이러한 퍼짐의 정도를 수치화하기 위해 분산을 사용한다.
[그림 삽입 권장: 평균은 같지만 분산이 다른 두 데이터셋 A와 B의 분포 비교]
Variance란 무엇인가?
Variance(분산)는 확률변수가 기댓값으로부터 얼마나 떨어져 있는지를 제곱하여 평균 낸 값이다.
수학적으로 다음과 같이 정의한다.
여기서 μ는 확률변수 X의 기댓값 E[X]를 의미한다.
이 수식을 단계적으로 생각하면 다음과 같다.
- 확률변수 X의 기댓값 μ를 구한다.
- 각 값에서 기댓값을 빼서 편차(Deviation)를 구한다.
- 각 편차를 제곱한다.
- 제곱한 편차의 기댓값을 계산한다.
결국 분산은 평균에서 떨어진 거리의 제곱을 확률적으로 평균 낸 값이다.
왜 편차를 제곱할까?
분산을 공부할 때 가장 먼저 헷갈리는 부분은 편차를 제곱하는 이유이다.
단순히 평균에서 얼마나 떨어져 있는지 알고 싶다면 각 값에서 평균을 빼기만 하면 되지 않을까?
앞서 살펴본 데이터셋 B를 다시 생각해보자.
| 관측값 | 평균과의 편차 | 편차의 제곱 |
|---|---|---|
| 2 | -2 | 4 |
| 4 | 0 | 0 |
| 6 | 2 | 4 |
편차를 그대로 더하면 -2 + 0 + 2 = 0이 된다.
즉 데이터가 평균에서 멀리 떨어져 있더라도 양수 편차와 음수 편차가 서로 상쇄되어 평균 편차는 0이 된다.
실제로 평균을 기준으로 계산한 편차의 합은 항상 0이다. 따라서 편차 자체를 단순히 평균 내는 방식으로는 데이터의 퍼짐을 측정할 수 없다.
편차를 제곱하면 무엇이 달라질까?
편차를 제곱하면 음수와 양수가 모두 0 이상의 값으로 변한다.
또한 평균에서 멀리 떨어진 값일수록 더 큰 제곱값을 가지기 때문에 큰 편차가 분산에 더 크게 반영된다.
예를 들어 편차가 2인 경우 제곱은 4이지만, 편차가 4인 경우 제곱은 16이다. 편차가 두 배가 되면 제곱한 값은 네 배가 된다.
제곱은 미분이 쉬운 함수이기도 하므로 최적화 문제에서도 다루기 편리하다.
분산에서 편차를 제곱하면 양수와 음수의 상쇄를 방지하고, 평균에서 크게 벗어난 값을 더 크게 반영할 수 있다.
물론 퍼짐을 측정하는 방법이 반드시 제곱이어야 하는 것은 아니다. 편차의 절댓값을 이용한 Mean Absolute Deviation(MAD) 같은 방법도 존재한다. 분산은 그중 제곱을 사용하는 대표적인 측도이다.
이산 확률변수의 Variance
이산 확률변수에서는 각 값과 그 값이 발생할 확률을 이용하여 분산을 계산한다.
pX(x)는 확률변수 X의 PMF(Probability Mass Function)이다.
각 값이 평균에서 얼마나 떨어져 있는지를 제곱하고, 그 값이 발생할 확률을 곱해서 모두 더하는 구조이다.
주사위의 분산 계산하기
공정한 주사위를 한 번 던졌을 때 나온 눈을 확률변수 X라고 하자.
앞선 글에서 주사위의 기댓값이 3.5라는 것을 확인했다.
이제 각 주사위 눈에서 3.5를 빼고 제곱한다.
| 주사위 눈 | 편차 | 편차의 제곱 | 확률 |
|---|---|---|---|
| 1 | -2.5 | 6.25 | 1/6 |
| 2 | -1.5 | 2.25 | 1/6 |
| 3 | -0.5 | 0.25 | 1/6 |
| 4 | 0.5 | 0.25 | 1/6 |
| 5 | 1.5 | 2.25 | 1/6 |
| 6 | 2.5 | 6.25 | 1/6 |
모든 편차의 제곱에 각각의 확률 1/6을 곱해서 더하면 다음과 같다.
따라서 공정한 주사위의 분산은 약 2.9167이다.
이는 주사위의 눈이 기댓값 3.5를 중심으로 얼마나 퍼져 있는지를 제곱 단위로 요약한 값이다.
분산 공식은 어떻게 변형될까?
분산을 계산할 때는 다음 공식도 자주 사용한다.
이 공식은 새로운 정의가 아니라 기존 분산의 정의를 전개한 결과이다.
분산 공식 유도하기
먼저 분산의 정의에서 시작한다.
괄호 안을 제곱해서 전개하면 다음과 같다.
기댓값의 선형성을 적용하면 각 항을 분리할 수 있다.
여기에서 μ=E[X]이므로 가운데 항은 -2μ²가 된다. 따라서 전체 식은 E[X²]-μ²로 정리된다.
최종적으로 다음 공식을 얻는다.
분산은 제곱의 기댓값에서 기댓값의 제곱을 뺀 값이다.
중요한 점은 E[X²]와 (E[X])²가 일반적으로 서로 다른 값이라는 것이다.
주사위에 적용하기
공정한 주사위에서는 E[X]=3.5이고, X²의 기댓값은 다음과 같다.
따라서 분산은 다음과 같이 계산할 수 있다.
기존 정의로 계산했을 때와 같은 결과를 얻는다.
Standard Deviation이란 무엇인가?
분산은 평균에서 떨어진 정도를 제곱하여 계산하므로 결과값의 단위도 제곱이 된다.
예를 들어 확률변수 X가 사람의 키를 cm 단위로 나타낸다면, 분산의 단위는 cm²가 된다.
이처럼 제곱된 단위는 원래 데이터와 직접 비교하기가 다소 불편하다.
따라서 분산에 제곱근을 적용하여 원래 데이터와 동일한 단위로 변환하는데, 이것이 Standard Deviation(표준편차)이다.
σ는 모집단 표준편차를 나타낼 때 자주 사용하는 기호이다.
공정한 주사위의 표준편차는 다음과 같다.
즉 공정한 주사위는 기댓값이 3.5이고 표준편차가 약 1.708이다.
표준편차는 기댓값 주변의 퍼짐을 원래 값과 같은 단위로 표현하지만, 개별 관측값이 평균에서 반드시 표준편차만큼 떨어져 있다는 의미는 아니다.
Variance와 Standard Deviation 비교
| 구분 | Variance | Standard Deviation |
|---|---|---|
| 한국어 | 분산 | 표준편차 |
| 의미 | 평균에서 벗어난 정도의 제곱 평균 | 분산의 양의 제곱근 |
| 단위 | 원래 단위의 제곱 | 원래 데이터와 동일한 단위 |
| 주사위 예제 | 약 2.9167 | 약 1.708 |
| 주요 활용 | 확률 모델링, 통계 이론 | 데이터의 퍼짐 해석, 표준화 |
연속 확률변수에서는 어떻게 계산할까?
이산 확률변수에서는 PMF를 이용한 합으로 분산을 구했다.
연속 확률변수에서는 PDF를 이용한 적분으로 분산을 계산한다.
여기서 fX(x)는 확률밀도함수(PDF)를 의미한다.
이산 확률변수에서 합을 사용하던 부분이 연속 확률변수에서는 적분으로 바뀌었을 뿐, 평균에서 떨어진 정도의 제곱을 가중평균한다는 원리는 동일하다.
단, 모든 확률분포가 유한한 분산을 가지는 것은 아니다. 분산이 유한하게 존재하려면 X²의 기댓값이 유한해야 한다.
모집단 분산과 표본분산의 차이
지금까지는 확률분포 자체의 분산을 다뤘다. 하지만 실제 통계 분석에서는 모집단 전체를 관측하기 어렵기 때문에 일부 데이터를 표본으로 추출하여 분산을 추정하는 경우가 많다.
이때 구분해야 하는 것이 Population Variance(모집단 분산)와 Sample Variance(표본분산)이다.
모집단 분산
모집단의 모든 값이 주어졌을 때 모집단 분산은 다음과 같이 계산한다.
여기서 N은 모집단의 크기이고, μ는 모집단 평균이다.
표본분산
모집단의 분산을 추정하기 위해 표본을 사용한다면 일반적으로 다음 공식을 사용한다.
여기서 n은 표본의 크기이고, x̄는 표본평균이다. 이 식은 n이 2 이상일 때 계산할 수 있다.
모집단 분산과 비교했을 때 가장 큰 차이는 분모가 n이 아니라 n-1이라는 점이다.
표본분산에서는 왜 n-1로 나눌까?
이 부분은 통계학을 처음 공부할 때 자주 헷갈리는 개념이다.
모집단의 실제 평균 μ를 알고 있다면 그 평균을 기준으로 편차를 계산할 수 있다. 하지만 일반적인 표본에서는 모집단 평균을 알지 못하므로 관측한 데이터로 계산한 표본평균 x̄를 사용한다.
문제는 표본평균이 바로 그 표본에서 계산되었다는 점이다. 표본평균은 같은 데이터의 평균이므로 관측값들이 표본평균에 상대적으로 가까워지도록 결정된다.
따라서 표본평균을 기준으로 계산한 편차의 제곱합을 단순히 n으로 나누면, 모집단 분산을 평균적으로 작게 추정하는 경향이 생긴다.
이를 보정하기 위해 일반적인 불편 표본분산에서는 n-1을 사용한다. 이 과정을 Bessel’s Correction이라고 한다.
자유도(Degrees of Freedom)와의 관계
표본평균을 계산한 뒤에는 편차들이 독립적으로 모두 결정될 수 없다.
예를 들어 세 개의 관측값이 있을 때 첫 번째와 두 번째 값의 편차가 결정되면, 세 번째 편차는 전체 편차의 합이 0이 되어야 하므로 자동으로 정해진다.
즉 평균을 이미 추정했기 때문에 편차 중 자유롭게 변할 수 있는 값은 n-1개이다.
이것이 표본분산에서 자유도 n-1이 등장하는 직관적인 이유이다.
표본평균을 같은 데이터에서 추정했기 때문에 자유도 하나가 사용되며, n-1로 나누면 일반적인 조건에서 모집단 분산을 불편추정할 수 있다.
단, n-1을 사용해야만 항상 올바른 것은 아니다. 표본을 전체 집단 자체로 해석할 때나 특정 통계적 추정 목적에서는 n을 사용할 수도 있다.
독립적이고 동일한 분포에서 추출한 표본이며 모집단 분산이 유한하다는 조건에서, n-1을 사용한 표본분산은 모집단 분산의 불편추정량이 된다.
Variance의 중요한 성질
분산 역시 몇 가지 중요한 수학적 성질을 가진다.
상수를 더해도 분산은 변하지 않는다
모든 관측값에 같은 숫자를 더하면 전체 분포의 위치만 이동할 뿐 평균 주변의 퍼짐은 바뀌지 않는다.
상수를 곱하면 분산은 제곱에 비례한다
데이터를 두 배로 확대하면 평균에서 떨어진 거리도 두 배가 되고, 이를 제곱하므로 분산은 네 배가 된다.
반면 표준편차는 원래 거리의 단위를 사용하므로 절댓값 기준으로 두 배가 된다.
두 확률변수의 분산을 더할 때
두 확률변수 X와 Y의 합에 대한 분산은 일반적으로 다음과 같다.
여기서 Cov(X,Y)는 두 확률변수의 공분산(Covariance)이다.
만약 X와 Y가 서로 독립적이라면 공분산은 0이 되므로 합의 분산은 각 분산의 합으로 단순화된다.
즉 기댓값의 합은 독립 여부와 관계없이 분리할 수 있지만, 분산의 합에서는 두 확률변수 사이의 관계를 함께 고려해야 한다.
머신러닝에서는 어떻게 활용될까?
분산과 표준편차는 머신러닝에서도 중요한 개념이다. 특히 데이터 전처리, 확률적 모델링, 예측의 불확실성 분석 등에 활용된다.
Feature Standardization
머신러닝에서는 입력 변수마다 서로 다른 단위를 가질 수 있다.
예를 들어 나이는 수십 단위이지만 연소득은 수천만 원 단위로 나타날 수 있다.
이러한 차이는 거리 기반 알고리즘이나 최적화 과정에 영향을 줄 수 있으므로, 평균과 표준편차를 이용한 Standardization(표준화)을 자주 사용한다.
이 변환은 평균을 0으로 이동시키고, 표준편차가 0보다 클 때 분산을 1로 만든다.
실제 머신러닝에서는 학습 데이터로부터 평균과 표준편차를 추정한 뒤 검증 및 테스트 데이터에도 동일한 값을 적용해야 한다. 데이터 누수를 방지하기 위해서이다.
Gaussian Distribution
분산은 Gaussian Distribution(정규분포)의 형태를 결정하는 주요 parameter 중 하나이다.
정규분포는 평균 μ와 분산 σ²로 표현한다.
평균은 분포의 중심을 결정하고, 분산은 분포가 얼마나 넓게 퍼져 있는지를 결정한다.
평균이 같더라도 분산이 작으면 값들이 평균 근처에 더 집중되고, 분산이 크면 분포가 더 넓게 퍼진다.
[그림 삽입 권장: 평균은 동일하지만 분산이 서로 다른 세 가지 Gaussian Distribution 비교]
모델의 예측 안정성과 Bias-Variance
분산은 학습 데이터 자체의 퍼짐뿐 아니라 모델이 학습 데이터의 변화에 얼마나 민감한지를 설명할 때도 사용된다.
예를 들어 서로 다른 학습 데이터셋으로 동일한 학습 절차를 반복했을 때 모델의 예측값이 크게 달라진다면, 해당 학습 절차의 예측 분산이 높다고 볼 수 있다.
이 개념은 머신러닝의 Bias-Variance Tradeoff와 연결된다.
다만 데이터의 분산과 모델 예측의 분산은 구분해야 한다. 두 경우 모두 분산이라는 수학적 개념을 사용하지만, 무엇을 확률변수로 정의했는지가 다르다.
Variance를 이해할 때 주의할 점
분산이 크면 항상 나쁜 데이터일까?
그렇지 않다. 분산이 크다는 것은 값들이 평균에서 더 넓게 퍼져 있다는 의미일 뿐이다.
어떤 상황에서는 변동성이 위험을 의미할 수 있지만, 다른 상황에서는 다양성이 크거나 정보량이 많은 데이터의 특성을 반영할 수도 있다.
따라서 분산의 크기만으로 데이터가 좋거나 나쁘다고 판단해서는 안 된다.
표준편차만 알면 분포를 이해할 수 있을까?
표준편차 역시 분포의 퍼짐을 요약하는 값이므로 분포 전체의 형태를 설명하지는 못한다.
서로 다른 형태의 분포가 동일한 평균과 표준편차를 가질 수 있다. 또한 정규분포가 아닌 경우 평균 ± 1표준편차 구간에 항상 약 68%의 데이터가 포함되는 것도 아니다.
약 68%라는 설명은 정규분포의 특성에 해당한다.
정리
Variance와 Standard Deviation에서 기억해야 할 핵심 내용은 다음과 같다.
- Variance는 확률변수가 기댓값에서 얼마나 퍼져 있는지를 나타낸다.
- 분산은 편차를 제곱한 값의 기댓값으로 정의된다.
- 편차를 제곱하면 양수와 음수의 상쇄를 방지하고 큰 편차를 더 크게 반영한다.
- 분산은 E[X²]에서 (E[X])²를 빼는 형태로 계산할 수도 있다.
- Standard Deviation은 분산의 양의 제곱근이며 원래 데이터와 동일한 단위를 가진다.
- 표본분산에서 n-1을 사용하는 이유는 표본평균을 추정하면서 발생하는 편향을 보정하기 위해서이다.
- 분산은 데이터 표준화, 정규분포 모델링, 예측 불확실성 분석 등에 활용된다.
- 평균과 분산을 모두 알아도 확률분포의 전체적인 형태를 항상 알 수 있는 것은 아니다.
Expectation이 분포의 중심을 나타낸다면, Variance는 그 중심에서 값들이 얼마나 퍼져 있는지를 나타낸다.
이제 하나의 확률변수가 가지는 평균과 퍼짐을 이해했다. 다음 단계에서는 두 확률변수가 서로 어떻게 변화하는지를 살펴볼 수 있다.
다음 글에서는 Covariance(공분산)가 무엇인지, 두 변수 사이의 관계를 어떻게 수치화하는지, 그리고 Correlation(상관계수)과는 어떤 차이가 있는지를 정리한다.
“`