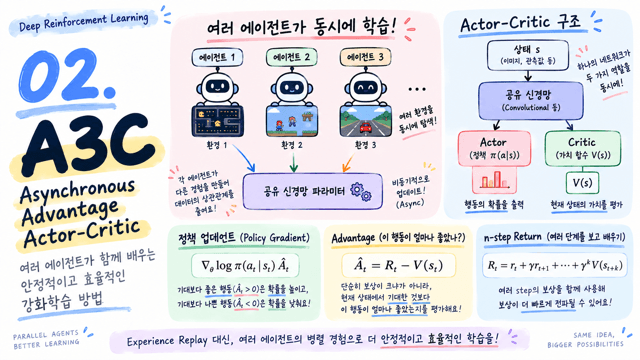
A3C 논문 정리: Experience Replay 없이 학습하는 Asynchronous Actor-Critic

jay
2026년 10월 2일 11:00
목차
이번 글에서는 Volodymyr Mnih 등이 ICML 2016에 발표한 “Asynchronous Methods for Deep Reinforcement Learning”을 정리한다.
이 논문은 흔히 A3C(Asynchronous Advantage Actor-Critic) 논문으로 알려져 있다. 다만 논문 자체는 A3C 하나만 제안하는 것이 아니라, 여러 강화학습 알고리즘을 비동기적으로 학습하는 프레임워크를 제안하고 그 안에서 네 가지 방법을 비교한다.
- Asynchronous one-step Q-learning
- Asynchronous one-step SARSA
- Asynchronous n-step Q-learning
- Asynchronous Advantage Actor-Critic, A3C
논문의 핵심 아이디어를 한 문장으로 정리하면 다음과 같다.
Experience Replay를 이용해 경험의 상관관계를 줄이는 대신, 여러 actor-learner를 서로 다른 환경에서 병렬로 실행하여 학습 데이터를 다양화하고 신경망 학습을 안정화한다.
1. 이 논문이 해결하려는 문제
DQN 계열의 Deep Reinforcement Learning에서는 agent가 환경과 순차적으로 상호작용하기 때문에 연속해서 수집한 데이터 사이에 강한 상관관계가 존재할 수 있다.
예를 들어 자동차가 코너를 돌고 있다면, 바로 다음 몇 개의 상태 역시 비슷한 화면과 위치를 가질 가능성이 높다.
s₁ → s₂ → s₃ → s₄ → s₅가 모두 비슷한 상황이라면, 이 데이터를 그대로 순서대로 신경망에 학습시키는 것은 학습 안정성 측면에서 문제가 될 수 있다.
DQN에서는 이를 완화하기 위해 Experience Replay를 사용한다. 과거 transition을 replay memory에 저장한 뒤 무작위로 sampling하여 학습하는 방식이다.
논문은 Experience Replay가 데이터의 시간적 상관관계와 non-stationarity를 줄이는 데 도움을 주지만, 동시에 몇 가지 제약을 가진다고 설명한다.
- 과거 경험을 저장하기 위한 메모리가 필요하다.
- 실제 환경과의 interaction 하나에 대해 추가적인 저장 및 sampling 연산이 필요하다.
- 과거 policy에서 생성된 데이터를 다시 사용하므로 주로 off-policy 알고리즘과 결합된다.
이 논문은 여기서 다른 접근을 제안한다.
경험을 하나의 Replay Buffer에 섞는 대신, 여러 agent가 동시에 서로 다른 경험을 만들게 하면 어떨까?
2. Asynchronous Learning의 핵심 아이디어
논문의 asynchronous framework에서는 여러 개의 actor-learner가 각각 자신만의 환경 instance와 상호작용한다.
개념적으로는 다음과 같은 구조다.
Actor 1 → Environment 1 ─┐

Actor 2 → Environment 2 ─┤

Actor 3 → Environment 3 ─┼→ Shared Parameters

Actor 4 → Environment 4 ─┤

Actor N → Environment N ─┘
각 actor가 서로 다른 환경 상태를 경험하기 때문에 하나의 agent가 연속적인 데이터만 만드는 경우보다 업데이트의 시간적 상관관계가 줄어들 수 있다.
논문에서는 이러한 parallel actor-learner가 DQN에서 Experience Replay가 수행하던 학습 안정화 역할을 일정 부분 대신할 수 있다고 설명한다.
또한 각 thread에 서로 다른 exploration policy를 적용하여 탐색의 다양성을 높였다.
왜 Asynchronous라는 이름이 붙었을까?
각 actor-learner는 자신의 환경에서 독립적으로 데이터를 생성하고 gradient를 계산한다. 이후 여러 thread가 공유 parameter를 비동기적으로 업데이트한다.
즉 모든 worker가 매 step마다 서로를 기다린 뒤 동시에 업데이트하는 방식이 아니다.
논문의 실험에서는 하나의 machine에서 여러 CPU thread를 사용하고, lock 없이 parameter를 업데이트하는 Hogwild 스타일의 방식을 사용했다.
3. 논문에서 비교한 네 가지 알고리즘
| 방법 | 계열 | 핵심 특징 |
|---|---|---|
| Asynchronous one-step Q-learning | Value-based | 1-step TD target을 이용하는 Q-learning |
| Asynchronous one-step SARSA | Value-based / On-policy | 실제로 선택한 다음 action을 이용해 target 계산 |
| Asynchronous n-step Q-learning | Value-based | 여러 step의 reward를 이용해 Q-value 업데이트 |
| A3C | Actor-Critic | Policy와 Value function을 함께 학습 |
중요한 점은 이 논문이 value-based 방법과 policy-based Actor-Critic 방법을 동일한 asynchronous framework 안에서 비교했다는 것이다.
4. Q-learning에서 Actor-Critic으로
Q-learning은 무엇을 학습하는가?
Q-learning 계열에서는 Action Value Function을 학습한다.
즉 현재 상태 s에서 action a를 선택했을 때 앞으로 받을 수 있는 return의 기대값이다.
DQN이나 DDQN에서는 각 action의 Q-value를 계산하고, 일반적으로 가장 높은 Q-value를 가지는 action을 기준으로 행동을 결정한다.
Policy-based 방법은 무엇이 다른가?
Policy-based 방법은 Q-value를 이용해 policy를 간접적으로 만드는 대신 policy 자체를 parameterize한다.
예를 들어 네 개의 action이 있다면 network가 다음과 같이 행동 확률을 직접 출력할 수 있다.
- Left: 0.10
- Right: 0.60
- Up: 0.20
- Down: 0.10
이때 Actor는 이 policy를 학습하는 부분이다.
5. Actor와 Critic은 각각 무엇을 하는가?
A3C는 policy와 value function을 동시에 유지한다.
- Actor: 어떤 action을 선택할지 결정하는 policy
π(a|s) - Critic: 현재 state가 얼마나 좋은지 평가하는 value function
V(s)
직관적으로 Actor가 행동하는 사람이라면 Critic은 그 행동의 결과를 평가하는 사람이라고 볼 수 있다.
논문의 실제 구현에서는 convolutional neural network의 일부 parameter를 공유하고, 마지막에 두 개의 output을 둔다.
- Softmax output: action probability를 나타내는 policy
- Linear output: state value를 나타내는 value function
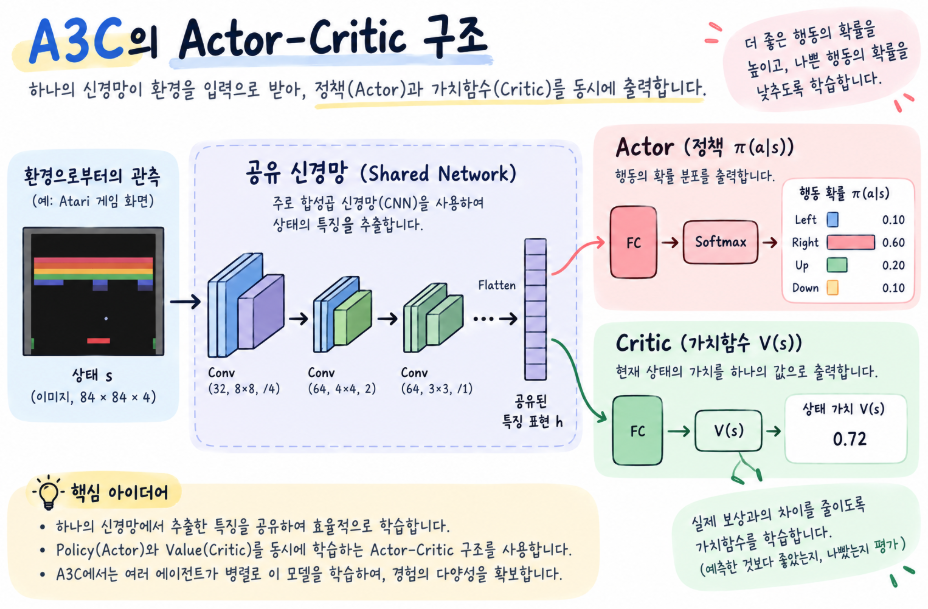
[직접 작성한 Actor-Critic 구조도 – Shared Network에서 Policy와 Value가 두 갈래로 출력되는 구조]
6. Advantage는 무엇인가?
Actor-Critic을 이해할 때 가장 중요한 개념 중 하나가 Advantage다.
Q(s,a)는 특정 action을 선택했을 때의 기대 return이고, V(s)는 현재 state에서 policy를 따랐을 때의 기대 return이다.
따라서 Advantage는 단순히 “보상을 많이 받았는가?”가 아니라, 현재 상태에서 기대했던 것에 비해 이 행동이 얼마나 좋았는가를 나타낸다고 이해할 수 있다.
예를 들어 어떤 상태 자체가 매우 유리해서 어떤 행동을 해도 높은 reward가 나온다고 생각해보자. 이 경우 reward가 높다는 이유만으로 선택한 action이 특별히 좋은 action이었다고 판단하기 어렵다.
이때 state의 기본적인 가치인 V(s)를 빼주면 특정 action이 평균적인 기대보다 얼마나 좋았는지를 평가할 수 있다.
7. A3C의 Policy Gradient
논문에서 Actor의 핵심 update는 다음 형태로 표현된다.
직관적으로 보면 다음과 같다.
- Advantage가 양수라면 해당 action의 선택 확률을 증가시키는 방향으로 update한다.
- Advantage가 음수라면 해당 action의 선택 확률을 감소시키는 방향으로 update한다.
즉 단순히 reward가 양수인지 음수인지를 보는 것이 아니라, Critic이 예상했던 값과 비교한다.
8. 왜 n-step Return을 사용하는가?
논문에서 A3C와 asynchronous n-step Q-learning은 여러 step의 reward를 함께 사용하는 n-step return을 사용한다.
마지막 항의 V(sₜ₊ₖ)는 아직 실제로 관측하지 않은 이후 return을 value function으로 추정하는 bootstrap 항이다.
논문에서는 1-step 방법의 경우 하나의 reward가 바로 앞의 state-action pair에만 직접 반영되고, 이전 state에는 여러 차례의 update를 통해 간접적으로 전달된다는 점을 설명한다.
n-step return을 사용하면 하나의 reward가 여러 개의 이전 state-action pair에 보다 직접적으로 반영될 수 있다.
A3C에서는 이렇게 계산한 return과 현재 value prediction의 차이를 이용해 Advantage를 추정한다.
9. Entropy Regularization은 왜 사용하는가?
Policy가 학습되면서 특정 action 하나에 너무 빠르게 확률이 몰리면 exploration이 부족해질 수 있다.
논문에서는 policy의 entropy를 objective에 추가하여 지나치게 이른 deterministic policy로의 수렴을 억제했다.
예를 들어 초기 학습 단계에서 다음과 같은 policy가 있다고 하자.
- Left: 0.25
- Right: 0.25
- Up: 0.25
- Down: 0.25
이 분포는 entropy가 높다. 반대로 하나의 action이 0.999에 가까운 확률을 가진다면 entropy가 낮다.
논문에서 entropy term은 exploration을 장려하는 목적으로 사용되었다. 즉 “항상 랜덤하게 행동하게 만든다”라기보다 policy가 너무 빨리 한 행동에 고정되지 않도록 하는 regularization에 가깝다.
10. 헷갈린 질문 1: Reward가 있는데 왜 Advantage가 또 필요한가?
먼저 직관적으로
높은 reward를 받았다는 사실만으로 해당 action이 특별히 좋은 행동이었다고 단정하기 어렵다.
애초에 그 state가 매우 유리한 상태였을 수도 있기 때문이다.
예를 들어 평균적으로 100점을 받을 수 있는 상황에서 105점을 받은 것과, 평균적으로 0점을 받을 상황에서 20점을 받은 행동을 단순 reward만으로 비교하는 것은 적절하지 않을 수 있다.
Advantage는 현재 state의 기대값을 기준선으로 사용한다.
결과가 예상보다 좋았는지, 나빴는지를 이용하여 policy를 업데이트하는 것이다.
논문의 근거
논문은 REINFORCE 계열의 policy gradient에서 return만 사용할 경우 발생하는 variance를 줄이기 위해 state-dependent baseline을 사용할 수 있다고 설명한다.
이 baseline을 value function으로 두면 Rₜ - V(sₜ)는 Advantage의 추정치로 해석할 수 있다.
오해하기 쉬운 표현
부정확한 표현: “Advantage는 reward에서 value를 빼는 값이다.”
더 정확한 표현: “이 논문의 A3C에서는 n-step return을 이용해 action value에 해당하는 결과를 추정하고, 여기에서 state value를 빼 Advantage를 추정한다.”
즉 즉시 reward 하나와 value를 단순 비교하는 개념은 아니다.
11. 논문의 Atari 실험
저자들은 Atari 2600 환경에서 asynchronous one-step Q-learning, SARSA, n-step Q-learning, A3C를 비교했다.
논문의 Figure 1에서는 Beamrider, Breakout, Pong, Q*bert, Space Invaders를 대상으로 학습 속도를 비교한다.
저자들의 실험에서는 asynchronous 방법들이 DQN보다 빠르게 학습하는 경향을 보였고, 이 비교에서 A3C가 세 가지 asynchronous value-based 방법보다 좋은 성능을 보였다.
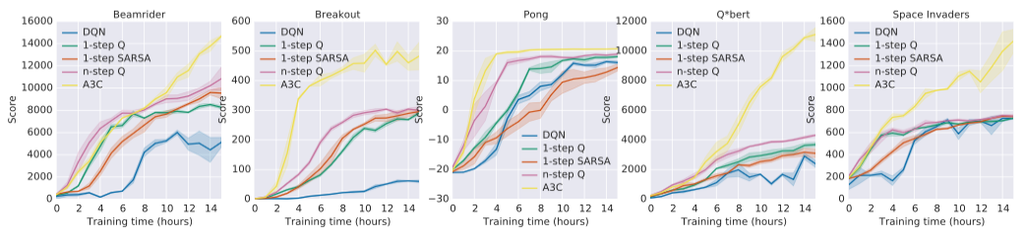
Figure 1 – DQN과 네 가지 asynchronous RL 방법의 Atari 학습 속도 비교
57개 Atari 게임 결과
논문은 이후 A3C를 총 57개 Atari 게임에서 평가하고 당시의 DQN 계열 결과와 비교한다.
| Method | Training | Mean | Median |
|---|---|---|---|
| DQN | 8 days on GPU | 121.9% | 47.5% |
| Double DQN | 8 days on GPU | 332.9% | 110.9% |
| Dueling Double DQN | 8 days on GPU | 343.8% | 117.1% |
| Prioritized DQN | 8 days on GPU | 463.6% | 127.6% |
| A3C, Feedforward | 4 days on CPU | 496.8% | 116.6% |
| A3C, LSTM | 4 days on CPU | 623.0% | 112.6% |
위 수치는 논문 Table 1의 human-normalized score다.
단, 이 표를 단순히 “A3C가 모든 DQN 계열보다 항상 우수하다”라고 해석하면 안 된다. 알고리즘별 training resource와 training protocol이 완전히 동일하지 않으며, 개별 게임별 성능 역시 차이가 있다.
논문에서 저자들이 강조하는 결과는 A3C가 당시 비교 대상에 대해 높은 평균 score를 보였고, 16개의 CPU core만으로도 경쟁력 있는 결과를 얻었다는 점이다.
12. Continuous Action에서 Actor-Critic의 특징
논문은 MuJoCo physics simulator를 이용한 continuous action task에서도 A3C를 실험했다.
여기서는 value-based 방법들은 평가하지 않고 A3C만 사용했다. 저자들은 Actor-Critic이 continuous action으로 쉽게 확장될 수 있다는 점을 이유로 든다.
Discrete action에서는 policy output으로 Softmax를 사용했지만, continuous action에서는 policy network가 정규분포를 구성하는 값을 출력하도록 했다.
- 평균: μ
- 분산: σ²
그리고 해당 distribution에서 실제 action을 sampling한다.
이는 action 하나하나의 Q-value를 비교해야 하는 구조와 달리, policy 자체가 연속적인 action distribution을 표현할 수 있다는 Actor 계열의 특징을 보여준다.
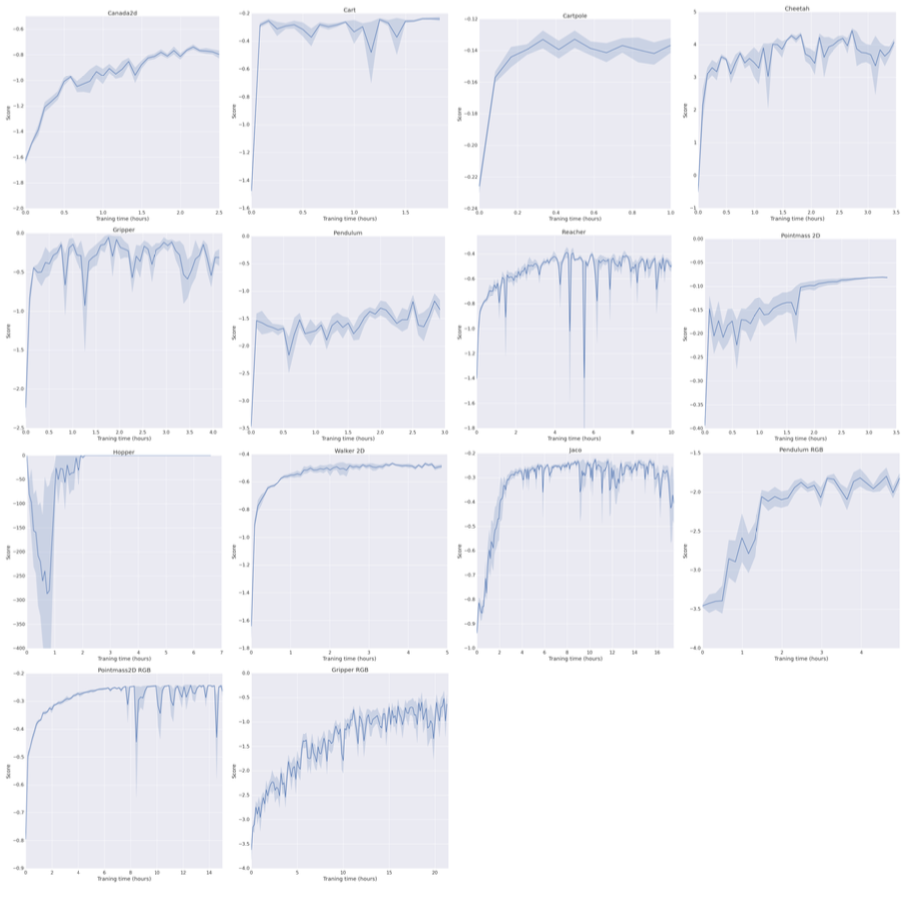
Figure S8 – MuJoCo continuous-control task에서 A3C의 학습 curve
13. Parallel Actor를 늘리면 얼마나 빨라지는가?
논문은 actor-learner thread의 수를 1, 2, 4, 8, 16개로 변경하며 scalability도 실험했다.
7개의 Atari 게임을 기준으로 저자들은 네 방법 모두 parallel worker 수가 증가하면서 wall-clock training time이 크게 단축되는 것을 관찰했다.
16개의 thread를 사용했을 때 네 방법 모두 평균적으로 한 자릿수 배 이상에서 20배 이상까지의 speedup을 보였으며, method에 따라 차이가 있었다.
다만 이를 “thread 수를 두 배 늘리면 항상 정확히 두 배 빨라진다”고 해석해서는 안 된다.
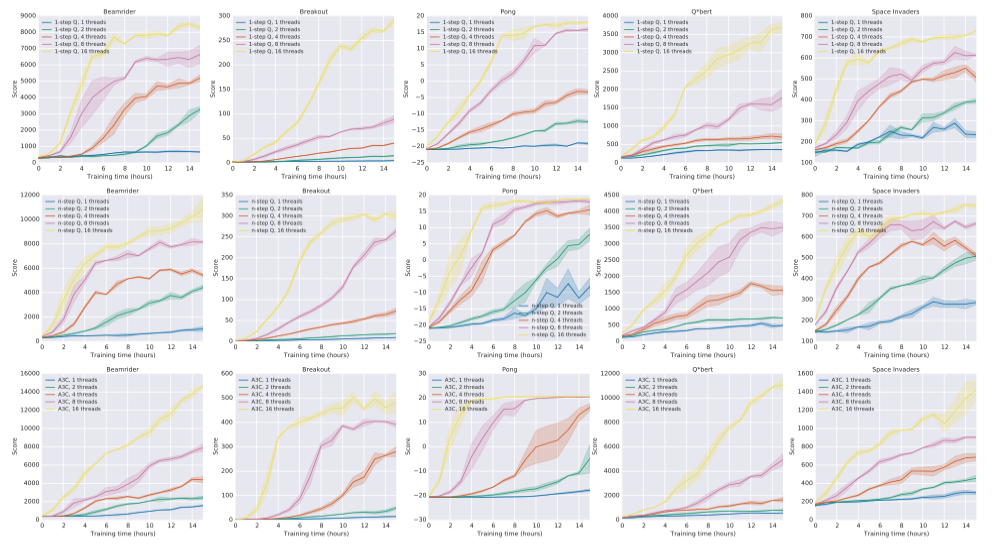
Figure 4 – actor-learner thread 수에 따른 wall-clock training speed 비교
14. 학습 안정성과 Robustness
저자들은 서로 다른 learning rate와 random initialization에 대한 robustness도 확인했다.
A3C의 경우 Beamrider, Breakout, Pong, Q*bert, Space Invaders에서 50개의 서로 다른 learning rate와 random initialization 조합을 실험했다.
논문에서는 여러 게임에서 좋은 성능을 보이는 learning rate의 범위가 존재했고, 적절한 learning rate 영역에서는 학습이 완전히 붕괴하는 경우가 드물었다고 보고한다.
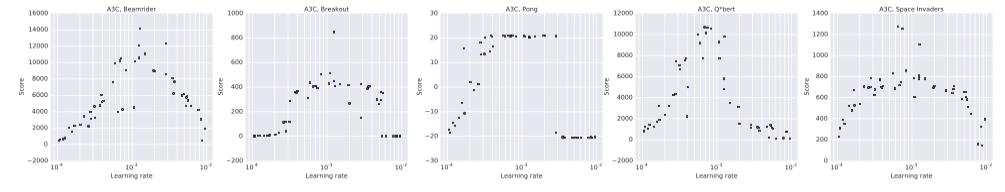
Figure 2 – A3C의 learning rate와 최종 score 관계
15. 논문이 실제로 제안한 것과 관찰한 것을 구분하면
| 구분 | 내용 |
|---|---|
| 제안 | 여러 actor-learner를 병렬로 실행하는 asynchronous deep RL framework |
| 제안 | one-step Q-learning, SARSA, n-step Q-learning, Advantage Actor-Critic의 asynchronous variant |
| 관찰 | Parallel actor가 neural network 학습을 안정화하는 효과를 보임 |
| 관찰 | 일부 Atari 환경에서 n-step 방법이 one-step 방법보다 빠르게 학습 |
| 관찰 | 실험한 asynchronous 방법 중 A3C가 강한 성능을 보임 |
| 관찰 | Actor 수가 증가하면서 wall-clock training time이 크게 감소 |
| 관찰 | A3C가 continuous-control 문제에도 적용 가능함 |
특히 “parallel actor가 왜 반드시 학습을 안정화하는가”가 이론적으로 일반적인 상황에서 증명된 논문이라기보다, 제안한 구조를 여러 benchmark에서 실험하여 안정적인 학습과 성능 향상을 관찰한 연구라고 이해하는 것이 정확하다.
16. 이 논문의 한계와 열린 질문
논문의 Conclusion에서는 저자들 스스로 여러 후속 연구 가능성을 제시한다.
- Experience Replay를 asynchronous framework와 결합하면 data efficiency를 개선할 가능성이 있다.
- A3C의 Advantage estimation에 Generalized Advantage Estimation과 같은 다른 방법을 사용할 수 있다.
- Value-based 방법에는 Q-value의 overestimation bias를 줄이는 기법을 결합할 수 있다.
- Dueling architecture와 같은 neural network 구조 개선도 적용할 수 있다.
특히 논문은 value-based 방법에서 Q-value의 overestimation을 줄이기 위한 방법으로 Double Q-learning 계열의 연구를 명시적으로 언급한다.
따라서 이 논문은 DDQN과 A3C 중 하나가 다른 하나를 대체한다고 주장하는 것이 아니다. 각각의 방법에서 얻어진 개선 아이디어를 asynchronous framework와 결합할 수 있다는 가능성을 열어둔다.
17. 공부하면서 정리한 핵심
이 논문을 읽고 반드시 가져가야 할 내용은 A3C의 이름을 외우는 것보다 다음 흐름이라고 생각한다.
- DQN은 Experience Replay를 이용해 연속 경험의 correlation을 줄인다.
- 이 논문은 여러 actor를 병렬로 실행하는 다른 접근을 제안한다.
- Actor는 policy를 학습하고 Critic은 state value를 추정한다.
- Advantage는 선택한 action이 현재 state의 기대보다 얼마나 좋았는지를 나타낸다.
- A3C는 n-step return을 사용해 Advantage를 추정한다.
- Entropy regularization은 policy가 지나치게 일찍 deterministic해지는 것을 억제한다.
- 실험에서는 asynchronous framework가 Atari, TORCS, MuJoCo, 3D maze 등 여러 환경에서 동작하는 것을 보였다.
You might also like
Comments (0)
Leave a Reply
Or login to comment with your account.
No comments yet. Be the first to share your thoughts!